清华大学、智元与无问芯穹联合提出了群体经验学习(Collective Experience Learning,CEL)范式:96台真机探索具身智能的规模化成长
October 30, 2026
以 GPT-6 Astra 为代表的前沿通用智能模型,已经在部分操作任务上展现出不错的零样本能力。但落地部署不能只看零样本表现,模型策略是否可靠更为关键。哪怕是业内最强的通用模型,机器人也容易在接触交互、对齐以及长流程任务执行中反复出错。
研究发现,加入人类动作示范可以有效提升模型可靠性。可问题在于:倘若每次能力升级都需要人工示范,当机器人大规模部署时,能提供示范的专家人力将跟不上扩张需求。
大洋彼岸,Physical Intelligence 也在关注这一问题。联合创始人 Sergey Levine 在近期访谈中指出,机器人起初需要人类采集的高质量示范来建立基础能力;能力成熟之后,便可以在真实世界里自主试错,利用自己采集的数据继续迭代学习。
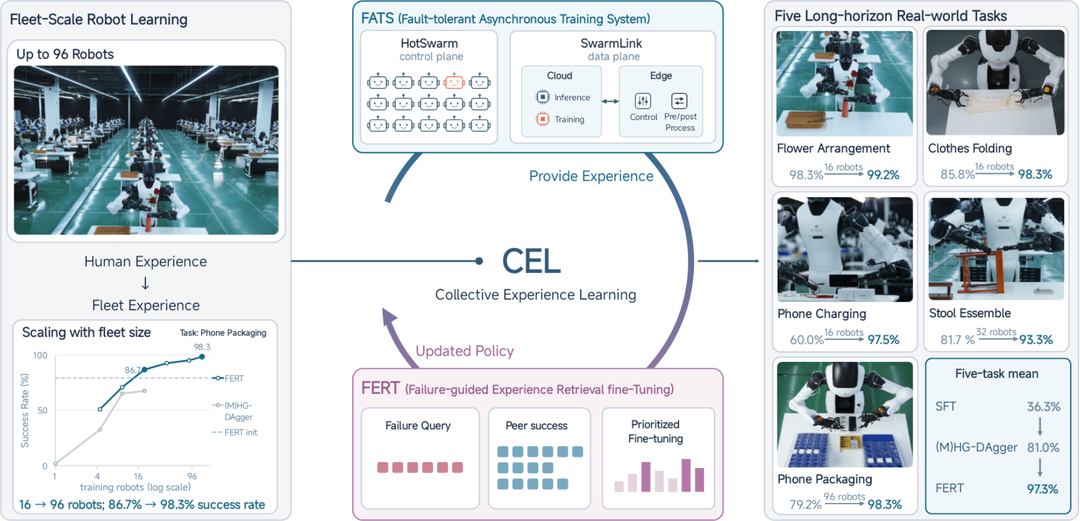
在相似的思考中,清华大学、智元与无问芯穹联合提出了群体经验学习(Collective Experience Learning,CEL)范式,并在 96 台机器人上完成了该学习范式的原型验证。在手机包装为代表的多阶段、长流程工业场景中,训练后的策略在两台未参与训练的同型号机器人上完成 120 次测试,成功率从 79.2% 提升至 98.3%。换成更直观的数字:同样 120 次测试,失败从 25 次降至 2 次,减少了 92%。
更值得关注的是规模带来的收益:在相同物理训练时间内,参与学习的机器人从 16 台增加至 96 台,测试成功率由 86.7% 提高至 98.3%。机器人数量的增加转化为了更可靠的任务执行能力。